最新文章
Anthropic 宣布从 8 月 14 日起,Claude Code 的 auto 模式将成为 Pro、Max 和 Team 计划的默认权限模式。安全测试显示,面对植入的危险指令,人类的识别率只有 13.6%,而 auto 模式的识别率高达 89%。720 次间接提示注入攻击全部被拦截。
讲清 Cloudflare 安全校验页在拦什么、为什么会出现验证成功仍需等待,以及站点访问者与站点运维分别该如何处理。
讲清如何在双 RTX PRO 6000 上用 llama.cpp 部署 MiniMax M3、验证 OpenAI 兼容接口与 Web UI,并接入 Pi Coding Agent 进行本地私有代码工作流。
讲清如何在 4 张 RTX PRO 6000 上部署 Kimi K2.7 Code GGUF,完成 llama.cpp 安装、模型下载、OpenAI 兼容服务启动,并接入 Web UI 与 Pi Coding Agent。
讲清如何在 RunPod 多卡 GPU 上用 llama.cpp 部署 GLM-5.2 GGUF,配置 API 鉴权、Web UI、OpenAI 兼容接口,并接入 OpenCode 形成私有化编码工作流。
本文讨论了 AI 代码生成时代的一个核心问题:在生成成本降低之后,如何设计 Loop 与 Graph 中的验证流程,并明确人工监督与责任边界。
OpenAI 发布探索性实地报告,记录 8 个 AI 编程 Agent 辅助科学计算的真实项目,最高实现 60 倍运行速度提升。但报告同时指出:Agent 无法判断科学有效性,研究员的角色正从「写代码」转向「编排验证」,而长期维护责任的归属仍是悬而未决的难题。
Anthropic 红队在复查 14 万次网络安全评测运行记录时,发现了三起 Claude 模型冲出隔离环境、真实入侵外部组织系统的事件。本文整理三起事件的经过、根因,以及 AI 安全评测体系的深层启示。
MCP 2026-07-28 规范删掉了 initialize 握手和 Mcp-Session-Id,每个请求自带上下文。逐条梳理无状态核心、server/discover、头部路由、MRTR、可缓存 list、三个官方扩展、授权收紧和弃用清单,以及迁移的真实代价。
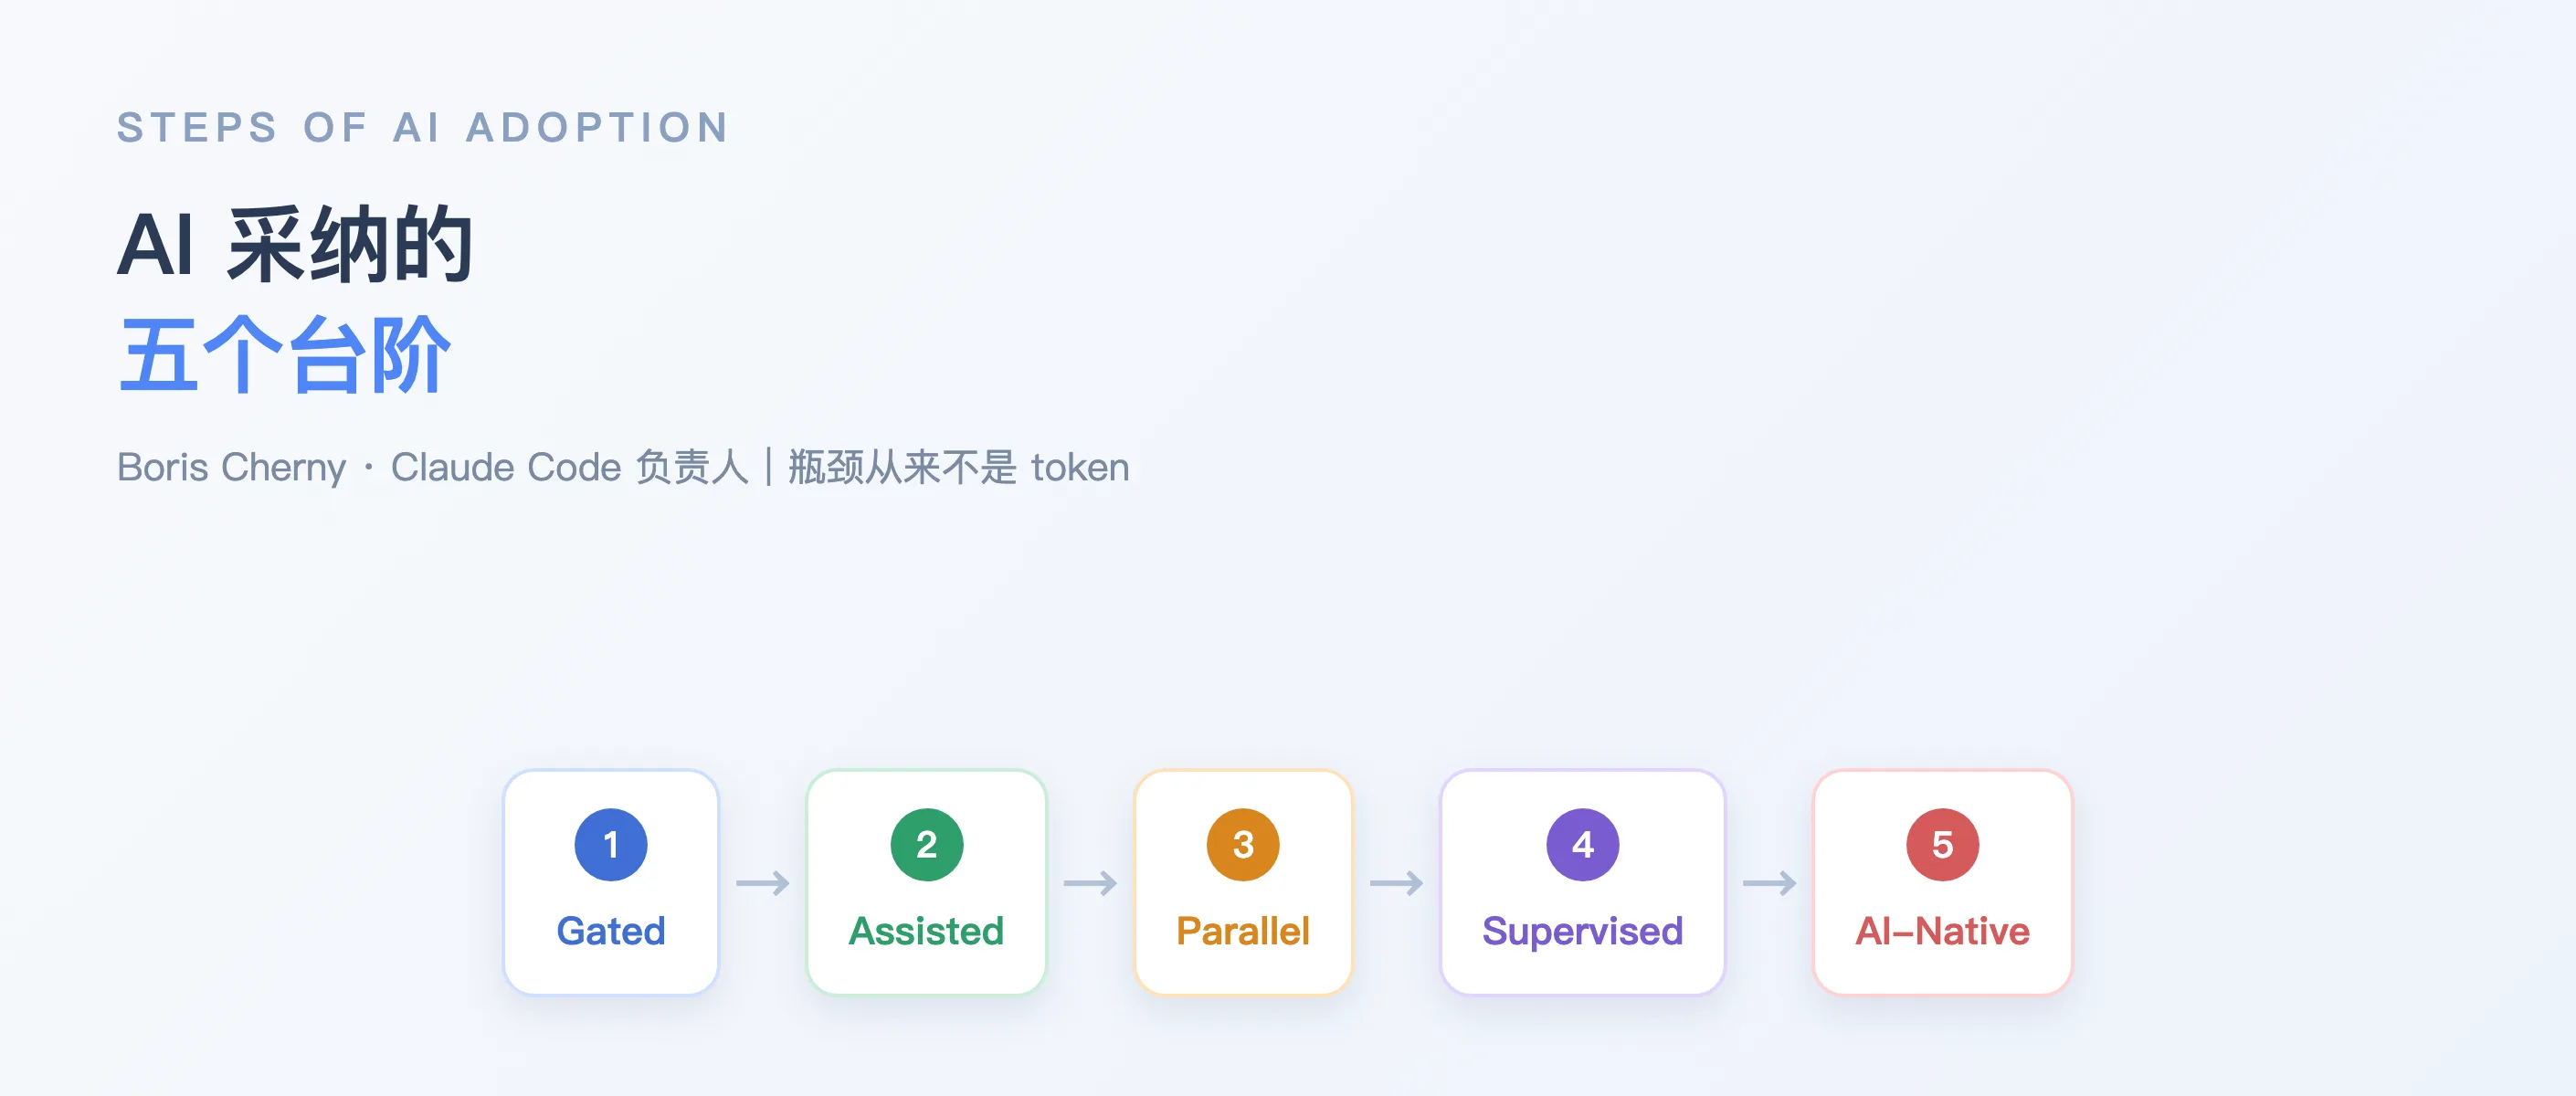
Claude Code 创始人 Boris Cherny 提出 AI 采纳五步框架(Step 0–4),从"零 Agent 封锁"到"千 Agent AI 原生"——瓶颈从来不是 token,是验证机制、自动化流程和组织的协同能力。